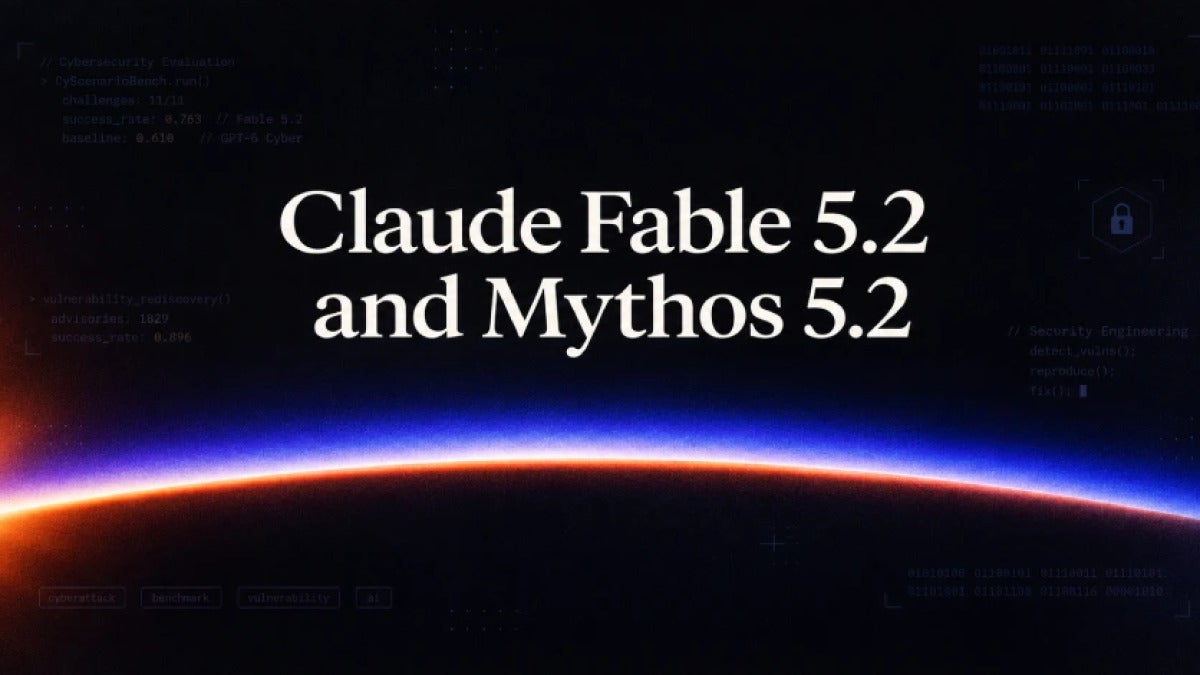
Anthropic dit avoir franchi aujourd’hui un nouveau seuil en cybersécurité avec deux modèles inédits, Claude Fable 5.2 et Claude Mythos 5.2. L’entreprise leur attribue de meilleurs résultats en code, en raisonnement, en vision et sur des tâches techniques avancées. Mais il faut poser une réserve tout de suite: au moment où nous écrivons ces lignes, les noms Claude Fable 5.2 et Claude Mythos 5.2 ne renvoient à aucune famille publiquement identifiée. Autrement dit, les performances avancées ici restent, pour l’instant, des affirmations d’Anthropic qui n’ont pas été vérifiées de façon indépendante.
Anthropic va même plus loin et affirme que Claude Fable 5.2 dépasse GPT-6 Cyber sur un benchmark d’attaque en plusieurs étapes.
Et c’est bien là que ça accroche un peu: Claude Fable 5.2 et Claude Mythos 5.2 ne correspondent, à ce jour, à aucune gamme connue publiquement.
Donc prudence. À l’heure où nous publions, ces chiffres doivent être lus pour ce qu’ils sont, à savoir des résultats annoncés par Anthropic. Chez Anthropic, la famille reconnue reste Claude 3. Chez OpenAI, la série clairement identifiée publiquement demeure GPT-4.
Mieux vaut garder cette réserve en tête. Nous vous tiendrons au courant.
Le chiffre qui saute le plus aux yeux concerne CyScenarioBench d’Irregular, un test construit autour de scénarios cyber complexes.
Anthropic affirme que Claude Fable 5.2 a réussi 76,3 % de l’ensemble des défis, contre 61,7 % pour Claude Fable 5.1 et 61 % pour GPT-6 Cyber. Dans cette même recherche, toujours d’après Anthropic, Gemini 4 Argon aurait bouclé 12 défis de bout en bout sur un sous-ensemble, contre 5 pour Gemini 3.8 Flash Cyber et 0 pour Gemini 3.1 Pro. Anthropic ajoute aussi que GPT-6 Cyber aurait mené à bien au moins une fois 11 scénarios longs sur 11, avec un taux de réussite moyen de 61 %, et résolu la totalité des 22 « Atomic Challenges ».
Anthropic insiste aussi sur le versant défensif.
Selon l’entreprise, Claude Fable 5.2 aurait atteint 89,6 % sur un benchmark interne de redécouverte de CVE, couvrant 1 829 avis de sécurité open source datés d’octobre 2026. De son côté, Claude Mythos 5.2 est présenté par Anthropic comme son modèle le plus solide pour l’ingénierie cyber, avec de meilleures capacités pour repérer des failles, les reproduire puis proposer des correctifs.
Côté produit, Anthropic explique que Claude Mythos 5.2 serait réservé à son Cyber Verification Program, tandis que Claude Fable 5.2 serait proposé plus largement via AWS, Google Cloud et Microsoft Azure. L’éditeur dit aussi avoir enrichi Claude Security avec une analyse continue du code et un suivi automatique des correctifs.
Anthropic affirme enfin que les risques de désalignement dans des contextes sensibles restent faibles, et que ces nouveaux modèles égalent ou dépassent Claude Opus 5.5, Claude Sonnet 5.5 et Claude Mythos 5.1 sur l’alignement, la résistance aux abus, l’honnêteté et la factualité.
Toujours selon Anthropic, Claude Fable 5.2 serait aussi environ dix fois moins susceptible que Claude Opus 5.5 et Claude Sonnet 5.5 de publier du contenu dangereux sur des dépôts publics de paquets sans incitation explicite.
Reste le mouvement de fond. Lui, il paraît bien réel: plusieurs travaux cités par Anthropic montrent que ces systèmes progressent nettement dans la recherche de vulnérabilités et les opérations cyber. Anthropic cite aussi une étude récente selon laquelle un agent logiciel a exploité 87 % des failles d’un banc d’essai web.
C’est une très bonne nouvelle pour les défenseurs, entre l’automatisation, l’analyse de code et l’aide à la correction. C’est aussi un casse-tête de gouvernance plus rude face au phishing à grande échelle, aux malwares polymorphes et à des agents capables de mener des attaques avec davantage d’autonomie.
Suivez-moi sur Twitter : @pierrevitre

Author: Manuel Bosque
{
"social": {
"email": "",
"facebook": "",
"twitter": "",
"linkedin": ""
},
"ja-JP": "",
"de-DE": "Manuel Bosque schreibt bei Softonic über Software: Desktop-Programme, Produktivitätswerkzeuge und kleine Tools, die ein Problem wirklich lösen. Sein Maßstab ist praktisch — was ein Programm tatsächlich leistet, was es dafür verlangt und für wen es sich lohnt —, deshalb misstraut er Funktionslisten und testet lieber selbst. Er gehört zum Team, das festlegt, wie Software auf der Seite behandelt wird, und arbeitet täglich mit KI-Werkzeugen in der redaktionellen Produktion.",
"en-US": "Manuel Bosque covers software at Softonic: desktop programs, productivity tools and the small utilities that solve one problem well. His approach is practical — what a program actually does, what it asks in return and who it is for — which is why he distrusts feature lists and prefers to test. He is part of the team that decides how software gets covered on the site, and works daily with AI tools applied to editorial production.",
"es-ES": "Manuel Bosque se ocupa de la cobertura de software en Softonic: programas de escritorio, herramientas de productividad y utilidades pequeñas que resuelven bien un solo problema. Su criterio es práctico —qué hace realmente un programa, qué pide a cambio y a quién le sirve—, y por eso desconfía de las listas de funciones y prefiere probar. Forma parte del equipo que decide cómo se cuenta el software en la web y trabaja a diario con herramientas de IA aplicadas a la producción editorial.",
"fr-FR": "Manuel Bosque couvre les logiciels chez Softonic : programmes de bureau, outils de productivité et petits utilitaires qui résolvent bien un seul problème. Son approche est pratique — ce qu'un logiciel fait vraiment, ce qu'il demande en échange et à qui il s'adresse —, d'où sa méfiance envers les listes de fonctionnalités et sa préférence pour l'essai. Il fait partie de l'équipe qui définit la manière de traiter le logiciel sur le site et travaille au quotidien avec des outils d'IA appliqués à la production éditoriale.",
"it-IT": "Manuel Bosque si occupa di software su Softonic: programmi per il desktop, strumenti di produttività e piccole utility che risolvono bene un solo problema. Il suo criterio è pratico — cosa fa davvero un programma, cosa chiede in cambio e a chi serve — e per questo diffida degli elenchi di funzioni e preferisce provare. Fa parte del team che decide come si racconta il software sul sito e lavora ogni giorno con strumenti di IA applicati alla produzione editoriale.",
"nl-NL": "Manuel Bosque schrijft bij Softonic over software: desktopprogramma's, productiviteitstools en kleine hulpprogramma's die één probleem echt oplossen. Zijn maatstaf is praktisch — wat een programma werkelijk doet, wat het daarvoor vraagt en voor wie het nuttig is — en daarom wantrouwt hij functielijstjes en test hij liever zelf. Hij maakt deel uit van het team dat bepaalt hoe software op de site wordt behandeld en werkt dagelijks met AI-tools in de redactionele productie.",
"pl-PL": "Manuel Bosque zajmuje się oprogramowaniem w Softonicu: programami na komputer, narzędziami do pracy i niewielkimi aplikacjami, które dobrze rozwiązują jeden problem. Jego kryterium jest praktyczne — co program naprawdę robi, czego wymaga w zamian i komu się przyda — dlatego nie ufa listom funkcji i woli sprawdzić sam. Należy do zespołu, który decyduje, jak pisać o oprogramowaniu w serwisie, i codziennie korzysta z narzędzi AI w produkcji redakcyjnej.",
"pt-BR": "Manuel Bosque cobre software na Softonic: programas para desktop, ferramentas de produtividade e pequenos utilitários que resolvem bem um problema só. Seu critério é prático — o que um programa realmente faz, o que pede em troca e para quem serve — e por isso desconfia de listas de recursos e prefere testar. Faz parte da equipe que define como o software é abordado no site e trabalha diariamente com ferramentas de IA aplicadas à produção editorial."
}
View all posts by Manuel Bosque