Skip to content

Softonic Deutsche

Just another Softonic Sites site

Author: Alyssa Lavinia Dellosa

{ "social": { "email": "content.reviewer8@ext.softonic.com", "facebook": "", "twitter": "", "linkedin": "" }, "ja-JP": "", "de-DE": "Alyssa Dellosa ist eine philippinische Produktinformationsspezialistin mit einem Abschluss in Pädagogik, die Menschen gerne dabei hilft, Technologie zu verstehen. Sie schreibt technische Produktblogs, korrigiert Artikel und verfasst ansprechende Social-Media-Beiträge.", "en-US": "Alyssa Dellosa is a Filipina Product Information Specialist with a degree in Education who loves helping people make sense of technology. Her path in content creation has led her through writing technical product blogs, proofreading articles in fields like home improvement, and crafting engaging captions for social media.", "es-ES": "Alyssa Dellosa es una especialista filipina en Información de Productos con licenciatura en Educación que disfruta ayudar a la gente a entender la tecnología. Escribe blogs técnicos sobre productos, corrige artículos y crea contenido cautivador para redes sociales.", "fr-FR": "Alyssa Dellosa est une spécialiste en information produit d'origine philippine, diplômée en éducation, passionnée par rendre la technologie accessible à tous. Elle rédige des articles techniques sur les produits, révise des contenus et crée des textes engageants pour les réseaux sociaux.", "it-IT": "Alyssa Dellosa è una specialista filipina di informazioni sui prodotti con una laurea in Pedagogia che adora aiutare le persone a comprendere la tecnologia. Scrive blog tecnici su prodotti, corregge articoli e crea didascalie accattivanti per i social media.", "nl-NL": "Alyssa Dellosa is een Filipijnse Product Information Specialist met een achtergrond in Educatie die graag mensen helpt technologie beter te begrijpen. Ze schrijft technische productblogs, corrigeert artikelen en maakt aantrekkelijke social media-posts.", "pl-PL": "Alyssa Dellosa to filipińska specjalistka ds. informacji o produktach z dyplomem w dziedzinie edukacji, która uwielbia pomagać ludziom zrozumieć technologię.", "pt-BR": "Alyssa Dellosa é uma Especialista em Informações de Produtos filipina com formação em Educação que adora ajudar as pessoas a entender tecnologia." }

Google Cloud kündigt neue Spezialmodelle für Forschung im Marketplace an

Google Cloud kündigt neue Spezialmodelle für Forschung im Marketplace an

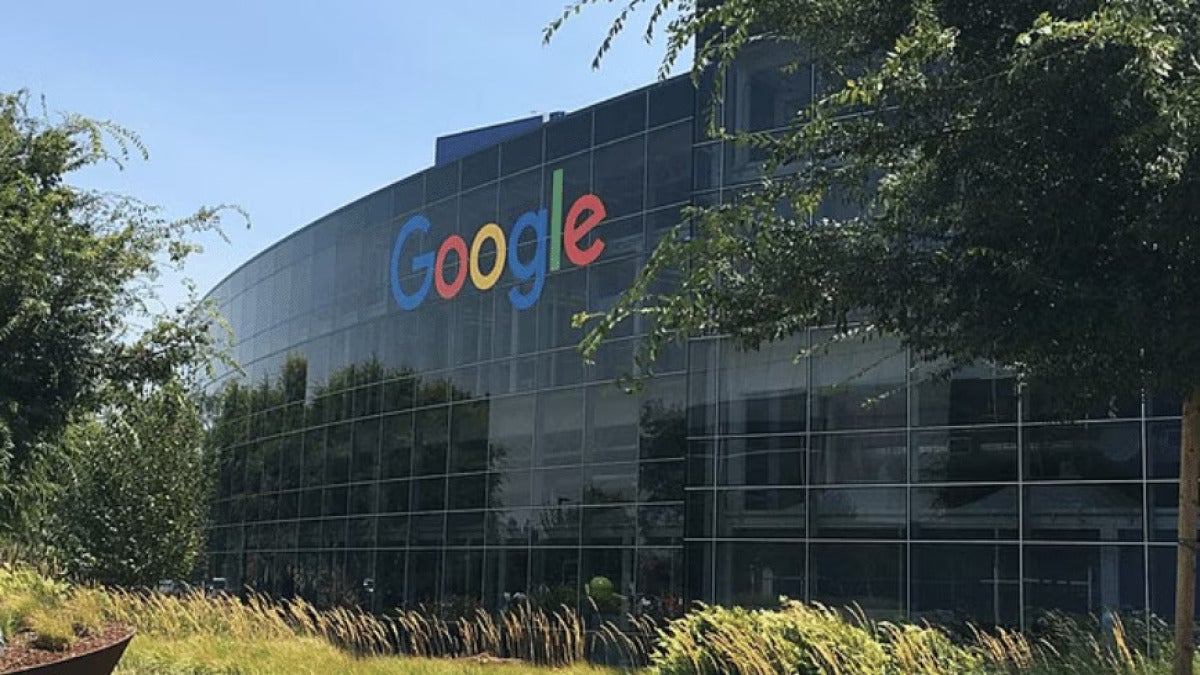
Google Cloud bringt die Large Quantitative Models, kurz LQMs, von SandboxAQ in den Google Cloud Marketplace. Gemeint sind spezialisierte KI-Modelle für wissenschaftliche Berechnungen. Gedacht sind sie laut Google Cloud für Forschung und Industrie, vor allem für Einsatzfelder wie Wirkstoffforschung, Materialwissenschaft und Anwendungen rund um Halbleiter.

Quantitative Modelle für wissenschaftliche Aufgaben

Für Google hat der Schritt strategisches Gewicht: Der Konzern setzt nicht allein auf allgemeine Sprachmodelle, sondern erweitert sein Angebot um Werkzeuge von SandboxAQ, die für Zahlen, Formeln und Messdaten gebaut wurden.

SandboxAQ ist Google Cloud zufolge 2022 aus Alphabets X-Abteilung hervorgegangen.

Im Zentrum stehen die sogenannten Large Quantitative Models. Im Unterschied zu klassischen großen Sprachmodellen wurden diese Systeme laut Google Cloud mit wissenschaftlichen Gleichungen, numerischen Datensätzen und Laborwerten trainiert.

Gerade in Chemie, Biologie und Physik soll das belastbarere Zahlen, Strukturen und Vorhersagen liefern, statt bloß gut klingende Texte.

Ergänzung zu Gemini

Google versteht die Modelle laut Google Cloud als Ergänzung zu den bestehenden Angeboten auf Google Cloud.

Wer wissenschaftliche Workflows über den Google Cloud Marketplace nutzt, kann Google Gemini für Sprache, Bedienung und allgemeines Schlussfolgern einsetzen. Die quantitativen Modelle übernehmen dann die eigentliche Berechnung und die Analyse, die Fachwissen aus der jeweiligen Domäne verlangt.

Als erste Modelle sollen nach Angaben von Google Cloud AQCat und später AQPotency in den Marketplace einziehen. AQCat ist auf Material- und Katalysatorforschung zugeschnitten, AQPotency auf die Wirkstoffentwicklung.

Schon kleine Fortschritte bei der Vorauswahl von Kandidaten sparen in diesen Bereichen viel Zeit und Geld. Auch wirtschaftlich ist das reizvoll: Der Markt für Wirkstoffforschung wurde 2025 laut Google Cloud auf rund 112 Milliarden geschätzt und könnte bis 2034 auf etwa 187 Milliarden wachsen. Für Google Cloud ist das ein lukratives Zielsegment, gerade weil auch andere große Cloud-Anbieter um wissenschaftliche Workflows konkurrieren.

Grenzen allgemeiner Sprachmodelle

Die Kooperation macht nebenbei auch sichtbar, wo aktuelle Sprachmodelle an ihre Grenzen kommen. Große Sprachmodelle sind stark, wenn es um Text geht, bei exakten Zahlen oder naturwissenschaftlichen Zusammenhängen aber deutlich weniger verlässlich.

In vielen Forschungsprozessen genügt ein sauber formulierter Absatz eben nicht, wenn am Ende eine präzise molekulare Struktur, ein Energiewert oder ein Materialprofil gebraucht wird. Deshalb werden spezialisierte Modelle wichtiger, die auf Messungen, Simulationen und konkrete Fachdomänen zugeschnitten sind.

Gemini for Science

Google hat außerdem, so Google Cloud, Gemini for Science vorgestellt. Das Paket für wissenschaftliche Arbeitsabläufe umfasst unter anderem den AI Co-Scientist, den Coding-Agenten AlphaEvolve, einen Assistenten für empirische Forschung und NotebookLM.

Laut Google geht es darum, repetitive und zeitintensive Schritte zu beschleunigen, nicht darum, Forschende zu ersetzen. Das fügt sich in Googles breiter angelegte Wissenschaftsstrategie ein, zu der auch Google-DeepMind-Arbeiten zur Proteinstruktur und Systeme zur Entdeckung neuer Materialien gehören.

Google folgt damit auch einem breiteren Trend: spezialisierte Modelle von Partnern über Cloud-Plattformen anzubieten, statt jede Fähigkeit selbst im Haus zu entwickeln.

Downloads: Download Google Cloud für Web
Author Alyssa Lavinia DellosaPosted on June 29, 2026June 29, 2026Categories NachrichtenTags Software

iLLaDA ist da: ByteDance stellt Konkurrenz zu Qwen2.5 vor

iLLaDA ist da: ByteDance stellt Konkurrenz zu Qwen2.5 vor

ByteDance und die Renmin University haben mit iLLaDA ein neues Sprachmodell mit 8 Milliarden Parametern vorgestellt. Laut iLLaDA-Paper arbeitet es mit einem Diffusionsansatz und misst sich in der Basisversion direkt mit Qwen2.5 7B. Text entsteht dabei nicht klassisch Wort für Wort von links nach rechts. Stattdessen startet iLLaDA dem Paper zufolge mit maskierten Tokens und verfeinert sie parallel über mehrere Schritte. Das Modell nutzt so bidirektionalen Kontext und kann Informationen von beiden Seiten eines Satzes gleichzeitig einbeziehen.

ChatGPT
ChatGPT Herunterladen

iLLaDA-Base im direkten Vergleich mit Qwen2.5 7B

Im Schnitt der Benchmarks kommt iLLaDA-Base laut iLLaDA-Paper auf 63,9 Punkte, Qwen2.5 7B auf 63,3. Der Vorsprung zeigt sich unter anderem in mehreren Wissens- und Reasoning-Tests: Auf MMLU erreicht iLLaDA laut Paper 74,8 statt 71,9 Punkte, auf BBH 71,3 statt 63,9, auf ARC-C 60,8 statt 51,5 und auf GSM8K 81,9 statt 78,9.

Aber eben nicht überall.

Bei Mathematik- und Coding-Aufgaben liegt Qwen2.5 7B laut iLLaDA-Paper teils weiter vorne. Trotzdem machen die Ergebnisse klar, dass ein Diffusionsansatz bei den Grundfähigkeiten nicht automatisch schlechter abschneiden muss.

12 Billionen Token als wichtiger Faktor

Ein wesentlicher Grund für diesen Sprung dürfte laut iLLaDA-Paper die breitere Trainingsbasis sein. iLLaDA wurde demnach von Grund auf mit 12 Billionen Token trainiert, das Vorgängermodell LLaDA mit 2,3 Billionen Token. Anschließend folgte laut Paper noch ein Fine-Tuning über 12 Epochen.

Im Vergleich zu LLaDA nennen die Forscher im iLLaDA-Paper unter anderem ein Plus von 21,6 Punkten auf BBH. Das legt nahe, dass nicht allein das Diffusionsprinzip den Ausschlag gibt, sondern auch das sehr viel umfangreichere Training hinter dem Leistungssprung steckt.

Instruct-Version noch hinter Qwen2.5 7B Instruct

Weniger eindeutig fällt das Bild bei iLLaDA-Instruct aus. Diese Variante bleibt laut iLLaDA-Paper hinter Qwen2.5 7B Instruct zurück, vor allem bei Mathematik und Programmierung. Die Autoren schreiben im Paper, dass Qwen2.5 hier wohl auch von zusätzlicher Ausrichtung durch Verstärkungslernen profitiert, die iLLaDA bisher noch nicht bekommen hat.

Das nimmt der starken Basisversion nichts. Es markiert aber die aktuelle Grenze: Ein gutes Grundmodell ist noch kein fertiges Produkt für den Alltag.

Vergleich mit Dream 7B und DiffusionGemma

iLLaDA schlägt laut iLLaDA-Paper außerdem Dream 7B, ein anderes Diffusions-Sprachmodell. Im Durchschnitt kommt iLLaDA auf 63,9 Punkte, Dream 7B auf 61,4, obwohl Dream auf einem Qwen2.5-Checkpoint basiert. Nur bei einigen Coding-Benchmarks hat Dream laut Paper leichte Vorteile.

Spannend ist auch der Unterschied zu Googles DiffusionGemma. Dort liegt der Schwerpunkt vor allem auf Geschwindigkeit. Berichten zufolge läuft Googles DiffusionGemma etwa viermal schneller, bleibt bei der Qualität aber hinter einem ähnlich großen autoregressiven Gemma-Modell zurück. iLLaDA setzt laut iLLaDA-Paper dagegen stärker auf Qualität und wurde als Dense-Modell mit 8 Milliarden Parametern komplett neu trainiert.

Die Veröffentlichung sendet damit ein ziemlich deutliches Signal: Diffusion ist bei Sprachmodellen längst mehr als nur ein Experiment. Modell und Code stehen bereits auf GitHub bereit. Die größte praktische Hürde bleibt die Inferenz, denn der Ansatz braucht nicht nur einen einzelnen Durchlauf, sondern mehrere Verfeinerungsschritte. Genau an diesem Punkt wird sich zeigen, ob aus dem Forschungserfolg am Ende auch ein breiter Praxiseinsatz wird.

Author Alyssa Lavinia DellosaPosted on June 27, 2026June 27, 2026Categories NachrichtenTags Software

Anthropic unter Klagedruck: Claude-Max-Abos sollen weniger leisten

Anthropic unter Klagedruck: Claude-Max-Abos sollen weniger leisten

Das KI-Unternehmen Anthropic bekommt in den USA juristischen Gegenwind. Wegen seiner kostenpflichtigen Claude-Abos liegt dort ein Antrag auf Sammelklage vor. Der Vorwurf des Klägers: Anthropic habe die Nutzungsgrenzen der Tarife Claude Max 5x und Claude Max 20x irreführend beworben.

ChatGPT
ChatGPT Herunterladen

Darum dreht sich die Klage gegen Anthropic

In der Klageschrift geht es um drei Claude-Abos von Anthropic: Claude Pro für etwa 17 bis 20 US-Dollar im Monat, Max 5x für 100 Dollar und Max 20x für 200 Dollar. Nach Darstellung des Klägers wirbt Anthropic bei den beiden Max-Tarifen damit, dass sie die fünffache beziehungsweise zwanzigfache Nutzung von Claude Pro ermöglichen.

Genau daran entzündet sich der Streit.

Kläger Karl Kahn wirft Anthropic in der Klageschrift vor, dass das Max-20x-Abo im Alltag nur ungefähr das Sechs- bis Achtfache der Pro-Nutzung zulasse, also deutlich weniger als die beworbenen 20x. Beim Tarif Max 5x liege die tatsächliche Nutzung laut Klage wohl eher bei rund dem 3,5-Fachen statt bei einer Verfünffachung.

Eingereicht wurde die Klage demnach beim Northern District of California.

Gefordert werden laut Klageschrift unter anderem Rückerstattungen für Abonnenten der Tarife Max 5x und Max 20x, rückwirkend ab April 2025. Außerdem soll ein Gericht feststellen, dass die Vermarktung dieser Pakete irreführend oder sogar betrügerisch gewesen sei. Auf Anfrage wollte Anthropic die Vorwürfe aus der Klageschrift demnach nicht kommentieren.

Konkreter Vorwurf: Limits früher erreicht als gedacht

Kahn schildert in der Klage auch ein ganz konkretes Nutzungsszenario. Er nutze Claude vor allem für Programmieraufgaben und habe nach dem Upgrade auf Max 20x überraschend schnell seine wöchentlichen Limits erreicht. In einem Beispiel, das in der Klageschrift genannt wird, soll schon eine einzige Sitzung von rund fünf Stunden 15 Prozent seines Wochenkontingents verbraucht haben.

Für Nutzer ist das heikel, weil ein Tarif mit „20x“ im Namen eine ziemlich klare Erwartung setzt.

Wenn sich dieser Wert im Alltag nur unter bestimmten Bedingungen erreichen lässt, die für Kunden kaum nachvollziehbar sind, könnte das aus Sicht von Verbraucherschützern zum Problem werden.

Kritik an der fehlenden Transparenz bei der Verbrauchsberechnung

Ein weiterer Kernpunkt der Klage ist die Frage, wie transparent Anthropic mit seinem System umgeht. Laut Klageschrift macht das Unternehmen nicht klar genug, wie der Verbrauch im Detail berechnet wird. Nutzer könnten daher kaum nachvollziehen, wie viel ihres Kontingents schon verbraucht ist oder warum ein Limit ausgerechnet in diesem Moment greift.

Gerade bei Diensten mit hohen Rechenkosten ist das ein sensibles Thema. Anbieter werben gern mit Abos, die auf den ersten Blick fast wie eine Flatrate wirken, intern arbeiten sie dann aber mit variablen Nutzungsgrenzen.

Juristen sehen in dem Verfahren deshalb einen frühen Testfall. Es geht um die Frage, wie Gerichte auf schwer verständliche Beschränkungen in solchen Abo-Modellen schauen werden.

Warum der Fall auch über Anthropic hinaus relevant ist

Der Streit kommt in eine Phase, in der die Regulierung spürbar zunimmt. Im US-Bundesstaat Connecticut wurde bereits ein Gesetz verabschiedet, das Unternehmen ab dem 1. Oktober dazu verpflichten soll, Nutzungsbeschränkungen offenzulegen, bevor Kunden ein Abo abschließen.

Falls die Klage Erfolg hat, hätte das wohl Folgen, die weit über Anthropic hinausreichen.

Anbieter kostenpflichtiger KI-Assistenten müssten ihre Tarifversprechen und Verbrauchsanzeigen dann sehr viel genauer formulieren, besonders bei Premium-Abos, die mit großzügigen Multiplikatoren werben.

Downloads: Download Claude für Android und iOS

Author Alyssa Lavinia DellosaPosted on June 19, 2026June 19, 2026Categories NachrichtenTags Software

OpenAI laut Bericht: 5,7 Milliarden Umsatz, 3,7 Milliarden Cash-Burn im ersten Quartal 2026

OpenAI laut Bericht: 5,7 Milliarden Umsatz, 3,7 Milliarden Cash-Burn im ersten Quartal 2026

Im ersten Quartal 2026 hat OpenAI laut einem Bericht 5,7 Milliarden US-Dollar Umsatz erzielt, gleichzeitig aber 3,7 Milliarden US-Dollar an liquiden Mitteln verbrannt.

ChatGPT
ChatGPT Herunterladen

Wachstum und Kosten laufen fast gleichauf

Damit floss laut Bericht deutlich mehr als die Hälfte des Quartalsumsatzes direkt wieder ab. Auffällig ist vor allem das Verhältnis zwischen Wachstum und Kosten: Im Jahresvergleich haben sich Umsatz und Ausgaben jeweils verdreifacht. Das Geschäft legt also mit enormem Tempo zu. Nur echte operative Skaleneffekte sind bisher kaum erkennbar. Mehr Kunden und eine intensivere Nutzung schlagen im Moment nicht automatisch in bessere Margen um.

Das Kerngeschäft selbst treibt die laufenden Kosten hoch

Ein wichtiger Grund steckt laut Bericht offenbar direkt im Kern des Geschäfts. Je stärker die leistungsfähigen Modelle genutzt werden, desto teurer wird ihr laufender Betrieb. Vor allem die Rechenleistung hinter Anfragen und Ausgaben kostet viel Geld, und mit dem Produkterfolg wächst dieser Posten gleich mit. Genau das erklärt laut Bericht, warum das kräftige Umsatzwachstum bislang noch keine spürbare finanzielle Entlastung bringt.

Viel Cash, allerdings vor allem dank einer Finanzierungsrunde

Microsoft Copilot
Microsoft Copilot Herunterladen

Trotz des hohen Cash-Burns hat OpenAI laut dem Bericht kurzfristig kein akutes Geldproblem. Das Unternehmen soll das Quartal mit mehr als 73 Milliarden US-Dollar an Cash und marktfähigen Wertpapieren beendet haben, nach rund 40 Milliarden US-Dollar Ende Dezember. Der starke Sprung geht laut Bericht allerdings in erster Linie auf frisches Kapital aus einer großen Finanzierungsrunde zurück und nicht auf einen Mittelzufluss, den das operative Geschäft aus eigener Kraft trägt.

Bewertung, Börsengang und neue Erwartungen

Kein Wunder also, dass Investoren jetzt genauer hinschauen dürften. Eine jüngste Finanzierungsrunde bewertete OpenAI Berichten zufolge mit rund 852 Milliarden US-Dollar. Zugleich soll OpenAI laut Berichten vertraulich einen Börsengang in den USA vorbereitet haben, der schon im September stattfinden könnte, bei einer Bewertung von bis zu 1 Billion US-Dollar. Bei solchen Summen steigen auch die Erwartungen: mehr Transparenz, mehr Disziplin und ein glaubwürdiger Weg in die Profitabilität.

Verluste und Ausgaben bleiben gewaltig

Die Dimension der Verluste bleibt erheblich. Nach Research-Einschätzungen steht für 2025 ein Nettoverlust von rund 39 Milliarden US-Dollar im Raum. Andere Schätzungen sehen den Fehlbetrag ohne nicht zahlungswirksame Effekte und Umbaukosten eher bei etwa 8 Milliarden US-Dollar. Für das erste Quartal 2026 ergab sich laut einer Analyse eine non-GAAP-operative Marge von minus 122 Prozent. Laut Bericht entfällt ein großer Teil der Ausgaben auf Rechenzentren, Forschung und den Ausbau der Infrastruktur. Für 2025 sollen sich die Gesamtausgaben dem Bericht zufolge auf 34 Milliarden US-Dollar belaufen haben, davon angeblich rund 19 Milliarden US-Dollar für Forschung und Entwicklung.

Der Druck auf dem Weg zur Profitabilität wächst

Damit reicht bloße Größe immer weniger aus. OpenAI hat laut Bericht signalisiert, wohl erst gegen Ende des Jahrzehnts profitabel werden zu wollen. Gleichzeitig verweisen Berichte auf Sorgen unter Investoren, auf eine schärfere Finanzdisziplin, mögliche Preissenkungen und auf ein ChatGPT-Nutzerwachstum, das teils hinter den internen Zielen zurückbleiben soll. Entscheidend ist am Ende also nicht nur, wie schnell OpenAI wächst. Sondern auch, wann aus diesem Wachstum tragfähige Erträge werden.

Quelle: Bericht

Author Alyssa Lavinia DellosaPosted on June 17, 2026June 17, 2026Categories NachrichtenTags Software

Posts pagination

Previous page Page 1 Page 2

Recent Posts

  • iPhone Duo vs iPad: Apple erklärt, warum wir beides wollen werden (oder vielleicht nicht)
  • Der Showrunner von Spider-Noir hat eine klare Vorstellung davon, wie eine hypothetische zweite Staffel der Serie aussehen würde
  • Das Festival von Venedig bricht einen Rekord: Ein Film hat 25 Minuten lang ununterbrochen Applaus bekommen
  • In China haben sie einen neuen Film von Tom und Jerry gemacht. Es ist das größte Desaster des Jahres.
  • Der Regisseur von ‚Spider-man: Brand New Day‘ wird eine der berühmtesten Serien der Geschichte adaptieren, die gerade erst ein Remake bekommen hat

Recent Comments

  • Scheer on Falsche Online-Rechnungen: Verseuchte E-Mails im Umlauf
  • Sveti on Falsche Online-Rechnungen: Verseuchte E-Mails im Umlauf
  • xxx on Falsche Online-Rechnungen: Verseuchte E-Mails im Umlauf
  • eric ebert on Alle Facebook-Smileys für Chats
  • WvO on Falsche Online-Rechnungen: Verseuchte E-Mails im Umlauf

Archives

  • September 2026
  • August 2026
  • July 2026
  • June 2026
  • May 2026
  • March 2026
  • February 2026
  • October 2025
  • April 2024
  • March 2024
  • February 2024
  • January 2024
  • December 2023
  • November 2023
  • October 2023
  • September 2023
  • August 2023
  • June 2023
  • April 2023
  • March 2023
  • February 2023
  • December 2022
  • September 2022
  • August 2022
  • July 2022
  • April 2022
  • March 2022
  • November 2021
  • February 2021
  • January 2021
  • October 2020
  • April 2020
  • March 2020
  • January 2020
  • May 2019
  • April 2019
  • February 2019
  • December 2018
  • November 2018
  • October 2018
  • September 2018
  • August 2018
  • July 2018
  • June 2018
  • April 2018
  • March 2018
  • February 2018
  • August 2017
  • May 2017
  • April 2016
  • February 2016
  • September 2015
  • July 2015
  • June 2015
  • May 2015
  • January 2015
  • December 2014
  • November 2014
  • October 2014
  • September 2014
  • August 2014
  • July 2014
  • June 2014
  • May 2014
  • April 2014
  • March 2014
  • February 2014
  • January 2014
  • December 2013
  • November 2013
  • October 2013
  • September 2013
  • August 2013
  • July 2013
  • June 2013
  • May 2013
  • April 2013
  • March 2013
  • February 2013
  • January 2013
  • December 2012
  • November 2012
  • October 2012
  • September 2012
  • August 2012
  • July 2012
  • June 2012
  • May 2012
  • April 2012
  • March 2012
  • February 2012
  • January 2012
  • December 2011
  • November 2011
  • October 2011
  • September 2011
  • August 2011
  • July 2011
  • June 2011
  • May 2011
  • April 2011
  • March 2011
  • February 2011
  • January 2011
  • December 2010
  • November 2010
  • October 2010
  • September 2010
  • August 2010
  • July 2010
  • June 2010
  • May 2010
  • April 2010
  • March 2010
  • February 2010
  • January 2010
  • December 2009
  • November 2009
  • October 2009
  • September 2009
  • August 2009
  • July 2009
  • June 2009
  • May 2009
  • April 2009
  • March 2009
  • February 2009
  • January 2009
  • December 2008
  • November 2008
  • October 2008
  • September 2008
  • August 2008
  • July 2008
  • June 2008
  • May 2008
  • April 2008
  • March 2008
  • February 2008
  • January 2008

Categories

  • Gaming
  • Gesponsert
  • Guides
  • Im Gespräch
  • Nachrichten
  • Noticias
  • Tipps und Tricks
  • Uncategorized

Meta

  • Log in
  • Entries feed
  • Comments feed
  • WordPress.org
Softonic Deutsche Proudly powered by WordPress