DeepSeek ha movido ficha con DeepSeek V4.1-Flash. La nueva versión de su modelo multimodal apunta a un problema muy concreto: abaratar el uso de contextos larguísimos sin que se disparen la memoria ni el ancho de banda. La compañía dice que mejora en rendimiento, velocidad y eficiencia frente a la generación anterior, y que lleva la ventana de contexto hasta 1 millón de tokens.
La cifra, por sí sola, impresiona menos de lo que parece. Lo interesante aquí no es tanto llegar al millón de tokens como intentar que ese tamaño tenga sentido fuera de una demo y pueda sostenerse en producción.
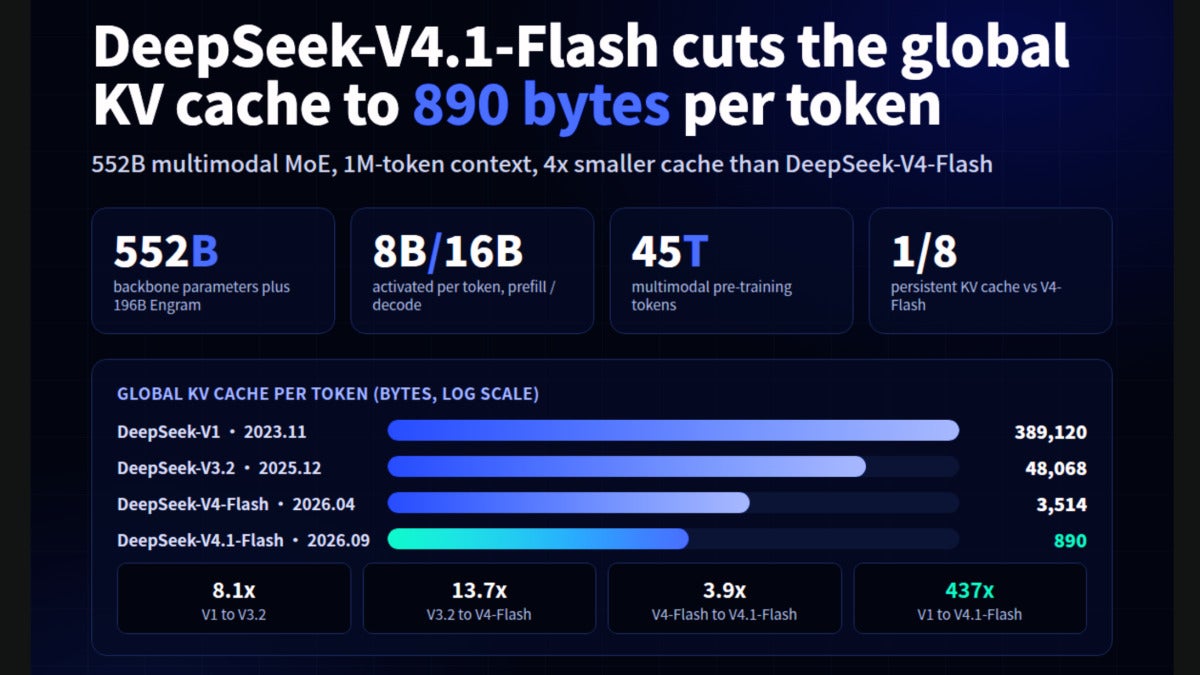
Ahí entra uno de los datos que más ha querido destacar la empresa. DeepSeek asegura que la huella global de caché KV baja hasta 890 bytes por token, más o menos una cuarta parte de la de DeepSeek-V4-Flash y unas 437 veces menos que en DeepSeek-V1.
También cambia bastante la forma en que se reparte el trabajo interno del modelo. Siempre según DeepSeek, V4.1-Flash usa una arquitectura multimodal de mezcla de expertos con 552.000 millones de parámetros de backbone y otros 196.000 millones de parámetros Engram. Pero no mueve todo eso a la vez: durante el prefill activa 8.000 millones de parámetros por token, y en decodificación sube a 16.000 millones.
Ese diseño responde a un cuello de botella muy específico.
DeepSeek sostiene que los agentes con horizontes largos y los prefills repetidos han convertido la caché KV en un problema operativo serio. Su respuesta pasa por recortar memoria y aliviar la presión sobre el ancho de banda cuando toca manejar historiales enormes, que es justo donde muchos sistemas empiezan a sufrir.
La base del modelo, explica la compañía, está partida en 40 capas. Se reparten en un codificador causal de 20 capas y un decodificador con otras 20.
A partir de ahí, la separación de tareas es bastante clara. Los tokens del prompt se quedan en el codificador, mientras que el decodificador recibe la KV global desde el estado oculto final del encoder. DeepSeek afirma que este reparto casi parte por la mitad el cómputo del prefill.
Claro que separar así encoder y decoder abre otro frente: cómo no perder atención local por el camino. Según la empresa, la ventana deslizante de 128 tokens sigue presente en todas las capas, y los estados SWA del decodificador se reconstruyen repitiendo solo los últimos 128 tokens del prompt mediante una técnica llamada Decoder SWA Bounded Replay.
Luego está Compressed Sparse Attention 2, o CSA2, que añade otra capa de compresión y reutilización. DeepSeek dice que las capas Full calculan KV e índices Top-512 nuevos, las Reindex vuelven a puntuar KV reutilizada y las Reuse directamente se saltan esa parte. En el decodificador, además, aparece un indexador jerárquico con grupos de candidatos de hasta 16.384 posiciones.
La caché KV principal también se comprime por cuantización. Según DeepSeek, la compañía la lleva a FP4, en concreto E2M1 con una escala E4M3 por cada 16 canales. La idea está inspirada en NVFP4 y se ha introducido mediante ajuste posterior con cuantización consciente; en almacenamiento, dicen, eso casi reduce a la mitad lo que ocupaba la caché FP8 de V4.
En distribución, el enfoque es bastante abierto. DeepSeek ha optado por licencia MIT, pesos abiertos y compatibilidad con vLLM, SGLang y Transformers en Hugging Face. A eso le suma una API pública con niveles de razonamiento low, high y max.
Los primeros comentarios de algunos probadores beta van en la línea que cabía esperar de un lanzamiento así: hablan de velocidades de hasta 427 tokens por segundo y de un rendimiento sólido tanto con contextos largos como en tareas de programación.
También hay movimiento en precios. DeepSeek ha recortado tarifas dentro de la familia V4 Flash y sostiene que DeepSeek V4.1-Flash puede sustituir a DeepSeek V4 Pro en rendimiento, rapidez y eficiencia de costes. Falta ver cuánto aguanta esa comparación cuando haya más pruebas externas: por ahora las evaluaciones independientes siguen siendo pocas, y ya han salido avisos de algunos beta testers sobre fallos multimodales y un comportamiento irregular en tareas como simulación física.
